IA Local
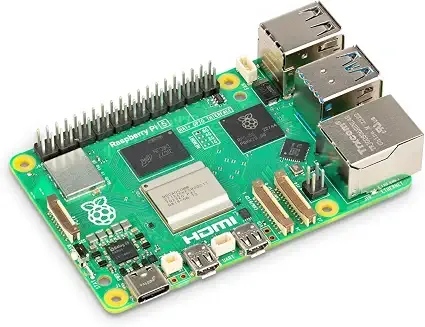
Hardware para correr modelos de IA en tu propia máquina, sin enviar tus datos a la nube: mini PCs con NPU, notebooks y workstations con GPU RTX y placas como Raspberry Pi 5 y Jetson AGX Orin. El dato clave es la memoria disponible: define qué tamaño de modelo puedes cargar.
Actualizado el 23 de octubre de 2026
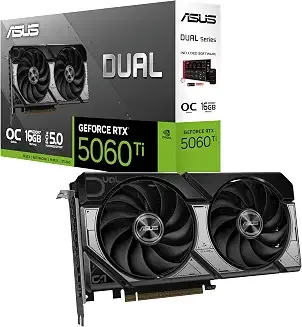
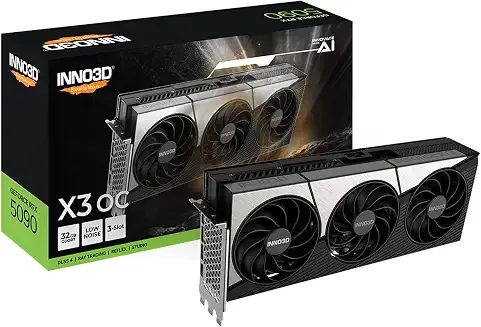
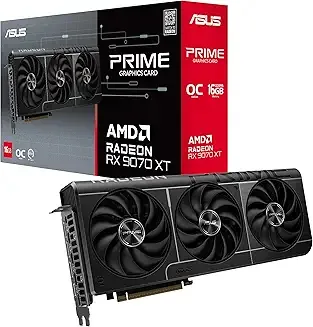
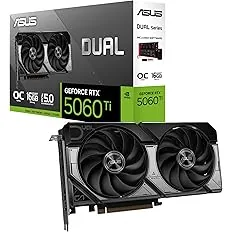
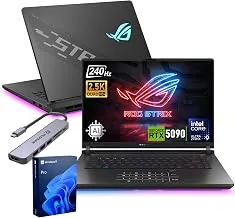
No hay productos con esos filtros.
Subtemas de IA Local
Cada subtema tiene su guía, su comparativa y sus preguntas frecuentes.
Calculadora de memoria para modelos de IA
Mueve el tamaño del modelo y la cuantización; abajo ves qué productos de la lista alcanzan.
— GB
de memoria estimada para correr el modelo
Estimación orientativa: pesos = parámetros × bytes por parámetro, más 15 % de margen y una memoria de contexto aproximada. El consumo real cambia según el motor (Ollama, LM Studio, llama.cpp) y la arquitectura del modelo.
Preguntas frecuentes
¿Cuánta VRAM necesito para IA local?
Como regla práctica, un modelo cuantizado a 4 bits ocupa unos 0,6 GB por cada mil millones de parámetros, más memoria para el contexto. Con 8 GB caben modelos de ~7B, con 16 GB de ~14B y con 32 GB de ~30B.
¿Sirve una Raspberry Pi 5 para IA?
Para modelos pequeños (1–3B cuantizados) y proyectos de aprendizaje sí; para conversar con fluidez con modelos medianos no es la herramienta adecuada.
¿Mini PC con NPU o GPU dedicada?
Una GPU dedicada ofrece más velocidad por modelo; un mini PC con mucha memoria unificada consume menos energía y permite cargar modelos mayores, aunque más lentos. Depende de si priorizas velocidad o tamaño de modelo.