Cuánta VRAM necesitas para correr IA local
Qué decide el tamaño de modelo que puedes correr
Los modelos de lenguaje deben caber en memoria rápida para responder con fluidez. En una GPU esa memoria es la VRAM; en un mini PC o un Jetson es la memoria unificada, compartida entre CPU y GPU. Más memoria permite modelos más grandes; más ancho de banda de memoria permite más tokens por segundo.
Cuantización: cómo caben más parámetros
La cuantización reduce el tamaño de cada parámetro. En 16 bits un parámetro ocupa 2 bytes; en 8 bits, cerca de 1; en 4 bits, alrededor de 0,6 con las variantes habituales. La calidad baja un poco al comprimir más, pero los modelos de 4 bits son el estándar para equipos de consumo.
Herramientas para empezar
Ollama y LM Studio permiten descargar y ejecutar modelos abiertos como Llama, Qwen o Mistral en Windows, Linux y macOS. Para integrarlos en tus propios proyectos, ambos exponen una API local.
GPU de escritorio, notebook o mini PC
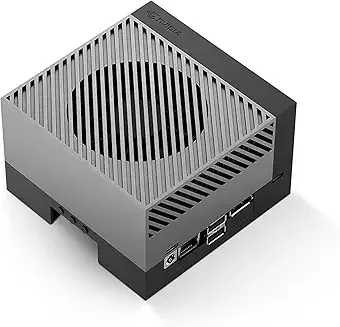
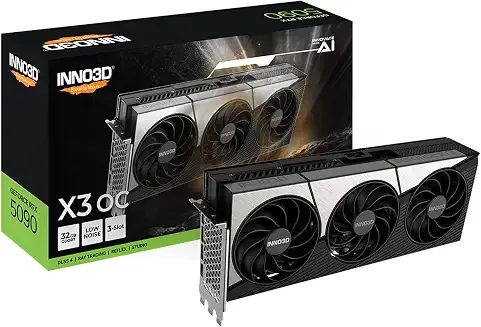
Una GPU de escritorio ofrece la mayor velocidad por modelo. Un notebook con GPU RTX es portátil, pero su VRAM suele ser menor que la versión de escritorio. Un mini PC con memoria unificada grande consume poca energía y carga modelos mayores, aunque responde más lento. El Jetson AGX Orin ofrece 64 GB de memoria unificada para IA en el borde.
Tabla de referencia (contexto de 8 000 tokens)
Solo se listan productos con memoria dedicada conocida (VRAM o memoria unificada). Estimación orientativa.
Calculadora de memoria para modelos de IA
Mueve el tamaño del modelo y la cuantización; abajo ves qué productos de la lista alcanzan.
— GB
de memoria estimada para correr el modelo
Estimación orientativa: pesos = parámetros × bytes por parámetro, más 15 % de margen y una memoria de contexto aproximada. El consumo real cambia según el motor (Ollama, LM Studio, llama.cpp) y la arquitectura del modelo.
Preguntas frecuentes
¿Cuánta VRAM necesito para un modelo de 7B?
Con cuantización de 4 bits, alrededor de 5 a 6 GB incluyendo margen y contexto, por lo que una tarjeta de 8 GB alcanza.
¿Sirve la RAM del sistema si me falta VRAM?
Sí: motores como llama.cpp reparten capas entre GPU y RAM, a costa de velocidad. Por eso un notebook con 64 GB de RAM ayuda a cargar modelos mayores.
¿Una Raspberry Pi 5 sirve para modelos de lenguaje?
Solo para modelos muy pequeños y cuantizados. Es una buena herramienta de aprendizaje, no de uso intensivo.